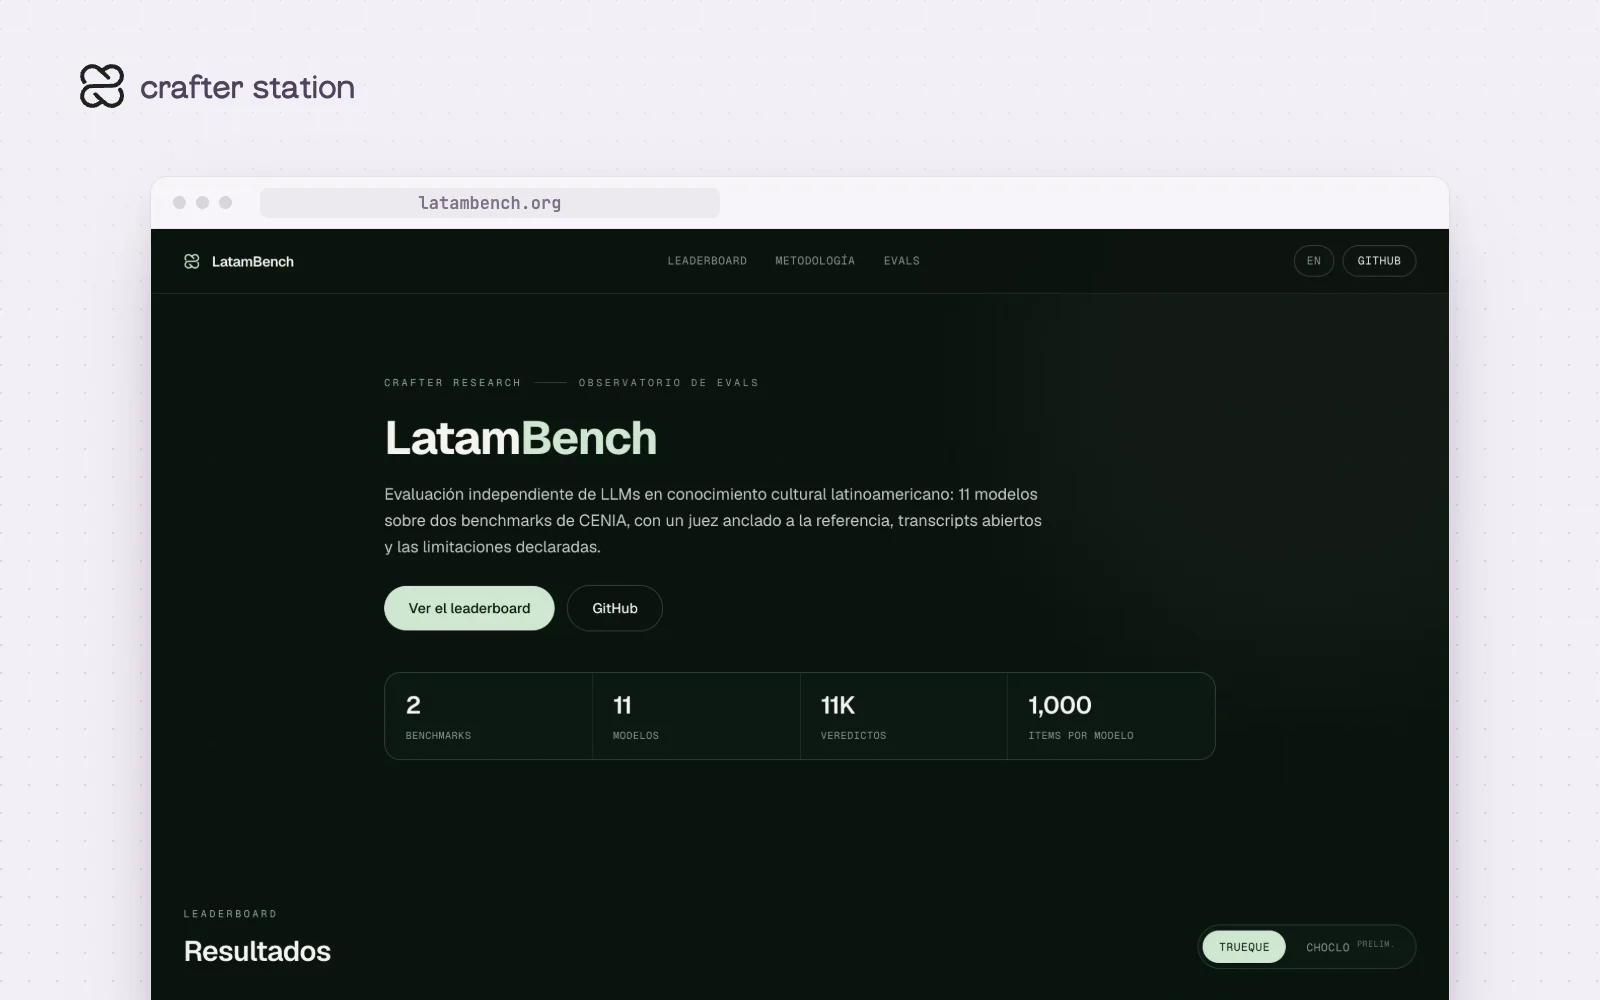
LatamBench es un leaderboard independiente que mide cuánto saben los modelos de lenguaje sobre la cultura latinoamericana. Vuelve a correr los benchmarks Trueque y CHOCLO con un juez anclado a las respuestas de referencia, publica cada transcript y audita los benchmarks en el camino. Lo construye Crafter Research y está en latambench.org.
Tres números por modelo#
La precisión cruda cuenta igual un "no sé" honesto que una respuesta inventada. LatamBench separa el resultado de cada modelo en correcto, abstención y alucinación, así se ve qué modelos inventan cuando fallan. En CHOCLO, el modelo regional LatamGPT alucina en el 53.2% de los ítems, el valor más alto del tablero.
Dos benchmarks auditados#
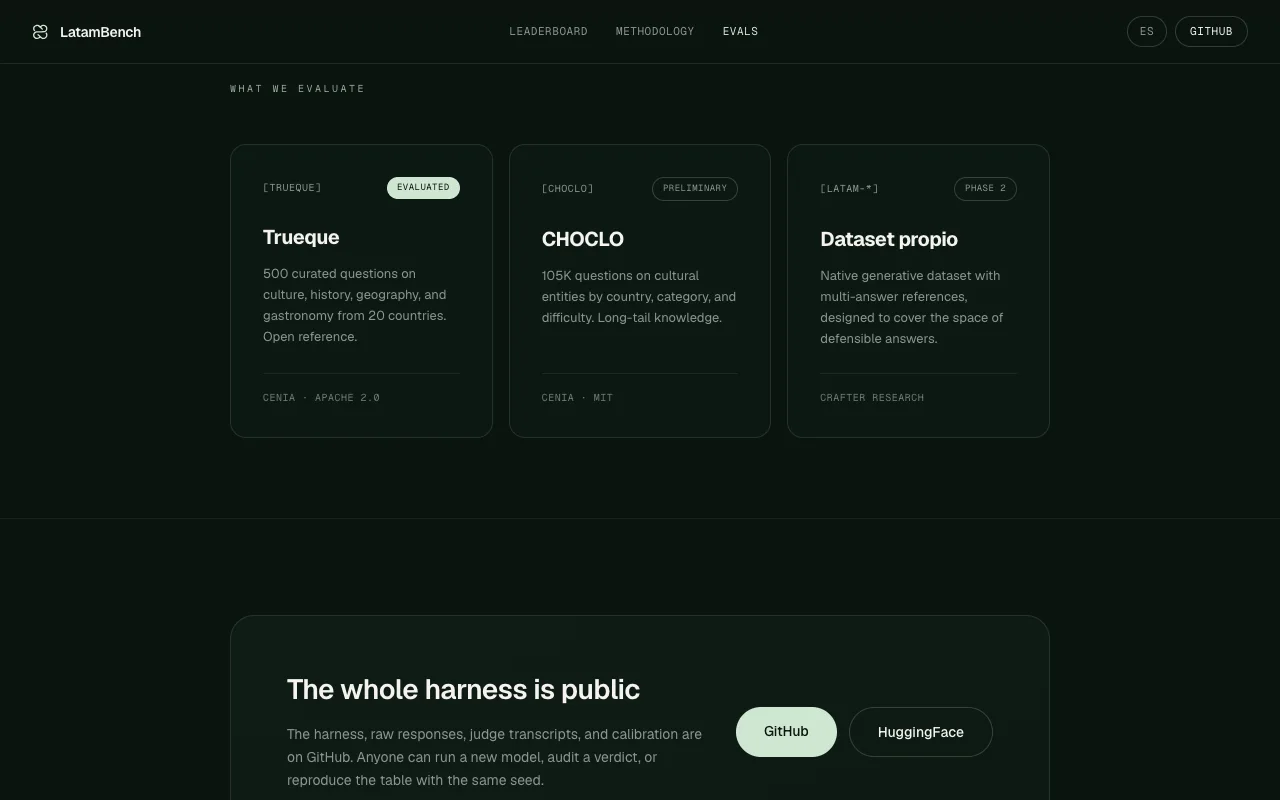
Trueque tiene 500 preguntas curadas sobre cultura, historia, geografía y gastronomía de 20 países. CHOCLO cubre entidades culturales de nicho por país, categoría y dificultad, y sus resultados están marcados como preliminares porque la calibración del juez solo cubre Trueque.
Pruébalo#
Revisa el leaderboard en latambench.org. Para auditar un veredicto o correr un modelo nuevo, el harness, las respuestas y los transcripts del juez están en el repositorio de GitHub, con seed 42 y temperatura 0 para que la tabla se reproduzca.